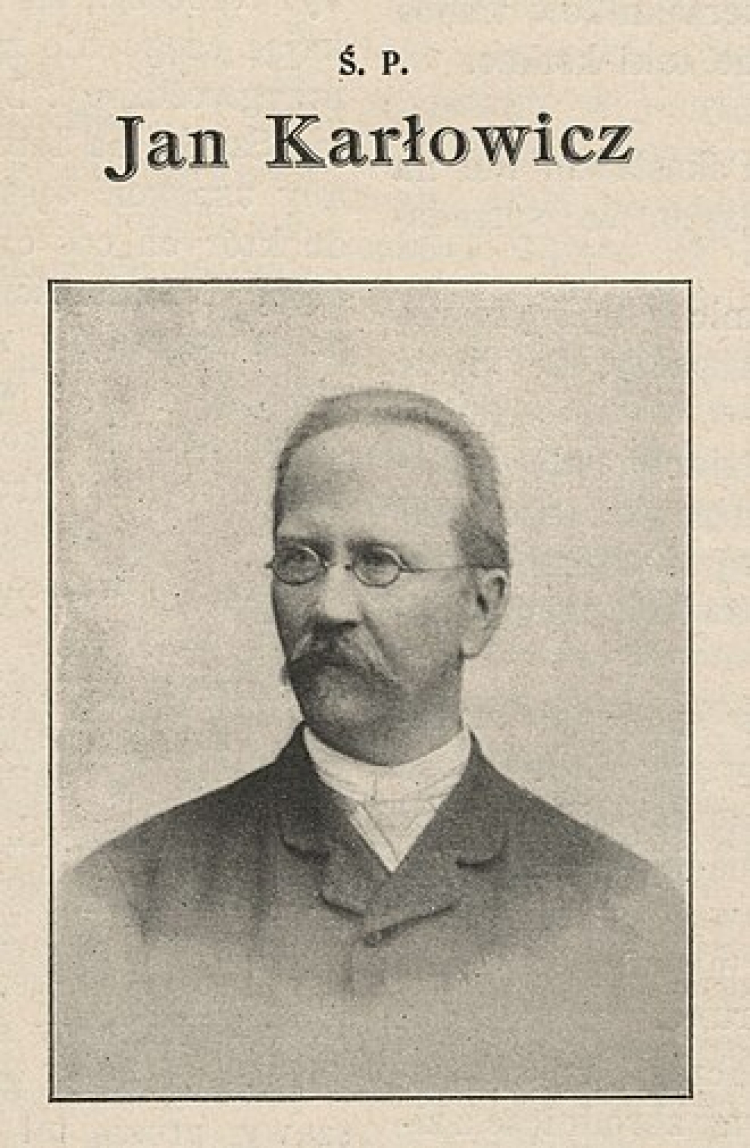
 Jan Aleksander Karłowicz (1836-1903). Fot. Mazowiecka Biblioteka Cyfrowa, Public domain, via Wikimedia Commons
Wydany blisko sto lat temu największy polski słownik - „Słownik Warszawski” - liczy prawie 7700 stron i ma ponad 260 tys. haseł. Cyfryzacji i przełożenia go na język współczesnych baz danych podjął się oddolnie dr Mirosław Koziarski. Online udostępnionych jest już ok. 86 tys. zdigitalizowanych haseł.
Mabdziurny (maleńki), imprezista (projektodawca), inamorować się (rozkochać się, zadurzyć się), labun (złodziej), kidoń (człowiek rozlewający jedzenie na ubranie) czy weredyk (człowiek wszystkim prawdę w oczy mówiący) - w „Słowniku Warszawskim” miłośnicy języka polskiego mogą odnaleźć m.in. niezwykły zbiór słów nie do końca dziś zrozumiałych.
– To stuletnie już prawie dzieło notuje bardzo wiele form nie tylko z języka ogólnego, ale też gwarowych, zapożyczeń czy okazjonalizmów. Słownik zawiera liczne błędy i niekonsekwencje, ale dla leksykografów to nieocenione źródło wiedzy – wymienił w rozmowie z PAP dr Mirosław Koziarski.
Słownik – opracowany przez zespół Jana Aleksandra Karłowicza, wybitnego etnologa i językoznawcy – opublikowano w latach 1900-1927 w ośmiu tomach. Oficjalnie zawierać miał on 280 tys. haseł (nowe wyliczenia pokazują jednak, że haseł jest mniej – ok. 265 tysięcy) i do dziś jest największym objętościowo polskim słownikiem.

Reprint pierwszego podręcznika do nauki języka esperanto po polsku
W ramach swojego doktoratu na Uniwersytecie im. Adama Mickiewicza w Poznaniu Mirosław Koziarski podjął się digitalizacji fragmentu słownika. Po doktoracie badania kontynuował hobbystycznie. We wrześniu br. podzielił się w Internecie dotychczasowymi wynikami – na razie to jedna czwarta słownika – ok 86 tys. haseł.
– Udostępniona przeze mnie platforma pozwala na wygodne przeszukiwanie dotychczas opracowanych haseł, analizę statystyczną i porównywanie haseł ze współczesnymi słownikami. Planuję sukcesywnie opracowywać kolejne tomy i rozwijać to narzędzie z myślą o badaczach oraz wszystkich pasjonatach języka – powiedział dr Koziarski.
Dr Koziarski pracuje w prywatnej firmie, a digitalizację słownika kontynuuje po godzinach. – Zdecydowałem robić to na własny koszt, a nie zabiegać o granty naukowe i później je rozliczać – powiedział. Dodał, że przed doktoratem brał udział w kilku projektach grantowych i biurokracja związana z tym systemem zniechęciła go do takiego modelu pracy.
– Widzę, ile energii moi koledzy i koleżanki na uczelniach muszą poświęcać na sprawy organizacyjne i grantowe. Ja wolę przeznaczyć ten czas na rzeczy, które sam uważam za ciekawe i warte zrobienia – dodał.
Największym wyzwaniem badawczym w digitalizacji była jakość dawnego OCR, czyli optycznego rozpoznawania znaków. – Kiedy zaczynałem pracę, przy tak specyficznym tekście pojawiało się od 100 do 150 błędów na skan jednej strony słownika. Technologie się jednak zmieniały i wykorzystanie nowoczesnych modeli AI pozwoliło zredukować tę liczbę do zaledwie kilku błędów na stronę – powiedział. O ile podczas doktoratu udało mu się scyfryzować ok. 80 stron słownika, o tyle teraz przez niecałe 3 miesiące opracował 2000 stron i całą platformę. Ponieważ jednak w oryginalnym tekście jest mnóstwo wyrazów dawnych, a i sam nie jest wolny od błędów, sztucznej inteligencji – wskazał dr Koziarski - nie można do końca wierzyć, bo łatwo o pomyłki i halucynacje.
Dodał, że jego cyfrowa wersja słownika również ma wiele niedociągnięć, dlatego do każdego hasła dołączone jest faksymile – można porównać cyfrową wersję ze skanem strony słownika i zgłaszać błędy.
Językoznawca PAN: kiedyś uważano, że kanikuła wywołuje obłęd
Drugim wyzwaniem w cyfryzacji słownika była interpretacja struktury. Żeby przygotować cyfrową wersję słownika, nie wystarczyło zeskanować dzieła i wyciągnąć tekstu ze skanu, ale trzeba było rozbić artykuł hasłowy na elementy składowe tworzące różne elementy bazy danych – wskazać, która część hasła zawiera definicję, która – etymologię (pochodzenie słów), która – zawiera przykłady użycia, a która uwagi gramatyczne. – Autorzy nie zawsze stosowali idealnie spójną typografię, więc stworzyłem szeroki system reguł hierarchicznych, które pozwalają komputerowi „zrozumieć” intencje autorów – wyjaśnił dr Koziarski. Dzięki temu można teraz łatwo badać np. liczbę zapożyczeń z danego języka czy tworzyć bazy cytatów literackich.
Pytany, czy nie dziwi go język uwieczniony w „Słowniku Warszawskim”, dr Koziarski odpowiedział, że samo przeglądanie haseł po kolei nie daje pełnego obrazu codziennej polszczyzny.
– Okres międzywojenny to czas scalania ziem z trzech zaborów. Wiele słowników z tamtego okresu – zwłaszcza specjalistycznych - powstawało po to, by wypierać spolszczone wyrazy niemieckie, rosyjskie czy francuskie rodzimymi odpowiednikami. Bardzo dużo słownictwa wymyślano z miesiąca na miesiąc na potrzeby budowy państwowości – wyjaśnił. I dodał, że „Słownik Warszawski” prezentuje język zamrożony w czasie, w momencie jego wydania.
Swoją drogą szybko po jego wydaniu okazało się, że w słowniku brakuje wielu słów, dlatego zaczął powstawać suplement słownika z kolejnymi 60 tys. haseł. Jedyna jego wersja zaginęła podczas drugiej wojny światowej.
– Tradycyjne słowniki są nietypowym gatunkiem literackim – ich się nie czyta od deski do deski, one w sobie mają wbudowany system wyszukiwania informacji, czyli są takim bardzo starodawnym sposobem budowania bazy danych. Przez to jednak, że ta baza danych jest w formie papierowej, to przeglądanie jej jest w pewien sposób narzucane. Dopiero oderwanie treści od papierowej formy (np. poprzez cyfryzację) pozwala na wydobycie ze słownika znacznie większej ilości informacji, które zazwyczaj pozostawały niewidoczne – powiedział dr Koziarski. I tak np. na podstawie opracowanych haseł powstał korpus językowy – zbiór przykładów językowych użytych w słowniku.
– Język jest w głowach ludzi, ale nie ma całego języka w żadnej jednej głowie. Nikt nie zna całego języka, chyba że byłby ostatnią osobą, która tym językiem mówi – podsumował badacz.
Słownik jest dostępny na stronie slownik-warszawski.pl.
Ludwika Tomala (PAP)